在人工智能基础软件开发的过程中,信息录入是连接现实世界与数字系统的关键环节。无论是训练数据、配置参数、用户输入,还是系统日志,都需要通过规范、高效、准确的方式录入到软件平台中,为后续的数据处理、模型训练和应用部署奠定基础。本节将围绕人工智能基础软件开发中信息录入的核心概念、技术方法、开发要点及典型应用展开阐述。
一、信息录入在人工智能基础软件开发中的定位
人工智能基础软件通常包括数据采集与管理、模型开发与训练、推理部署、以及配套的配置与监控模块。信息录入贯穿这些模块的始终:
1、数据采集阶段:将结构化数据(如数据库记录、传感器读数)和非结构化数据(如文本、图像、音频)录入数据管理平台,形成可被模型使用的数据集。
2、配置与参数录入:开发者通过配置文件、命令行参数或图形界面向软件系统录入超参数、模型结构定义、资源分配策略等。
3、运行时输入:应用系统接收用户输入或外部事件信息,将其转化为模型可处理的张量或特征向量。
因此,信息录入模块的设计质量直接影响数据质量、开发效率和系统可靠性。
二、信息录入的基本流程与技术要求
一个完整的信息录入流程一般包括:输入源接入、格式解析与校验、数据清洗与转换、持久化存储、以及录入日志与审计。在人工智能基础软件开发中,尤其需要关注以下技术要求:
1、多模态支持:能够接收文本、图像、音频、视频、结构化表格等多种数据类型,并提供统一的录入接口。
2、格式兼容性:支持JSON、CSV、Parquet、TFRecord、HDF5等常见数据格式,以及自定义二进制格式。
3、数据校验:对录入字段进行类型、范围、完整性校验,避免脏数据进入训练流程。例如,图像尺寸与通道数校验、标签合法性检查、空值处理策略等。
4、批量与流式录入:既支持离线批量导入大规模数据集,也支持实时流式录入(如Kafka、MQTT等消息队列接入),满足不同场景需求。
5、元数据管理:为每条录入数据附加来源、时间戳、标注信息、版本号等元数据,便于数据溯源与版本控制。
6、安全与权限:对敏感信息进行脱敏或加密,通过身份认证与访问控制限制录入操作。
三、信息录入的功能模块设计
在人工智能基础软件中,信息录入通常以独立模块或微服务形式存在;以下是一个典型的功能模块划分:
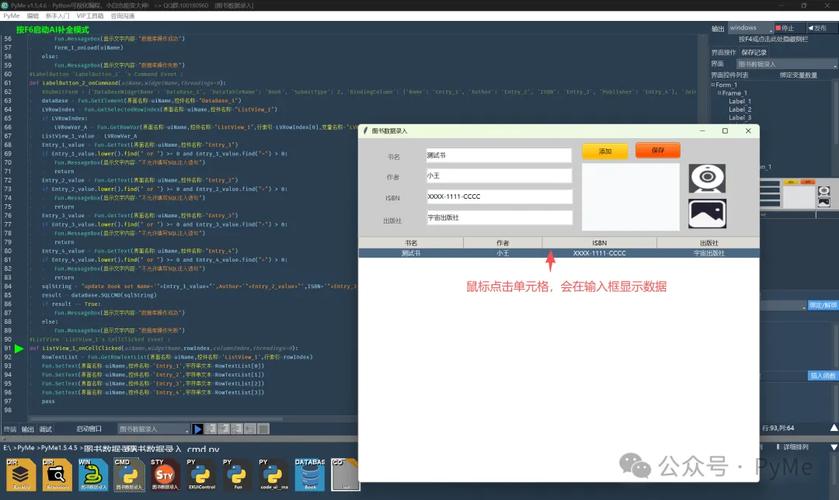
1、录入接口层:提供命令行工具、RESTful API、gRPC接口、SDK以及Web界面上传入口。开发者可根据场景选择同步或异步录入方式。
2、解析与适配层:负责识别输入格式,调用对应的解析器,将原始数据转换为内部统一表示。对于非结构化数据,可集成预处理组件(如图像解码、音频重采样、文本分词)。
3、校验与清洗层:执行schema校验、去重、缺失值填补、异常值过滤等操作,并生成校验报告。
4、存储适配层:将清洗后的数据写入对象存储、分布式文件系统、关系数据库或向量数据库,并更新数据索引。
5、日志与监控层:记录每次录入操作的状态、耗时、数据量、错误信息,提供审计追踪和告警能力。
四、开发实践中的关键考虑
1、schema演进:人工智能项目的数据模式往往随需求变化而调整。录入模块应支持schema的向后兼容演进,例如新增可选字段、字段类型放宽等,避免历史数据失效。
2、幂等性设计:批量录入任务可能因网络中断或系统故障重试,需通过唯一标识(如数据哈希或业务主键)保证重复录入不产生冗余数据。
3、可扩展性:采用插件化解析器架构,便于新增数据类型和格式;存储层抽象接口,支持切换不同后端存储。
4、性能优化:对于大规模数据录入,采用分片并行、流式读写、压缩传输等手段提升吞吐量;对实时录入场景,需控制端到端延迟。
5、错误处理与人机协同:对无法自动解析或校验失败的数据,提供隔离区(quarantine)存储和人工复核界面,避免整批录入任务因个别异常数据而失败。
五、典型应用场景示例
1、计算机视觉数据平台:开发者通过批量上传工具将图像数据集录入系统,工具自动完成图像解码、尺寸校验、标签关联和缩略图生成,并将元数据写入数据库,供后续标注和训练使用。
2、自然语言处理实验管理:研究者在配置文件中录入语料路径、分词器参数、最大序列长度等信息,实验管理软件解析配置并校验合法性,随后启动数据预处理流水线。
3、边缘推理设备配置:运维人员通过管理界面向边缘AI设备录入模型版本、输入输出映射、阈值参数等,系统校验后下发至设备,完成推理服务的动态配置。
六、小结
信息录入是人工智能基础软件开发中不可或缺的基础能力。它以标准化、可校验、可追溯的方式将多源异构信息转化为系统可处理的数据资产,并通过合理的架构设计和工程实践保障数据质量与开发效率。掌握信息录入模块的设计原则与实现方法,是构建健壮、可扩展的人工智能基础软件的重要一步。